神经信息处理系统大会(Conference on Neural Information Processing Systems,NeurIPS)是人工智能与机器学习领域的国际顶级会议,与ICML、ICLR并称为“机器学习领域的三大顶会”。该会议每年举办一次,涵盖机器学习、计算机视觉、自然语言处理、强化学习等人工智能前沿研究方向。NeurIPS 2026将在澳大利亚悉尼举行。本次会议主会共收到30,709篇有效投稿,经专家严格评审,共录用7,900篇论文,录用率为25.7%。复旦大学大数据研究院共有4篇论文入选,相关成果围绕视频世界模型、多模态大模型内生安全、多模态视频分割等人工智能前沿方向展开。
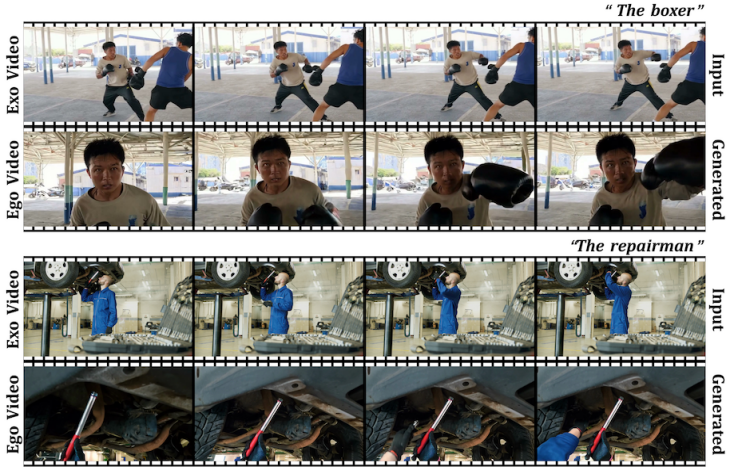
视频世界模型:跨视角推演第一视角视觉世界
Seeing the World through Any Eyes
如何基于第三视角观察推演第一视角视觉世界,是视频世界建模中的重要问题。然而,不同视角间巨大的视觉差异、有限的内容重叠以及不同的相机运动给视频生成带来挑战。为此,本文提出EgoEye,通过第一视角上下文推理与跨视角运动对齐,从单个第三视角视频生成真实且时序一致的第一视角视频。本文进一步构建大规模数据集EgoScape,为跨视角视频生成与世界建模研究提供新的数据基础。
论文作者:付杨,王建钦,李祥泰,丁恒辉*
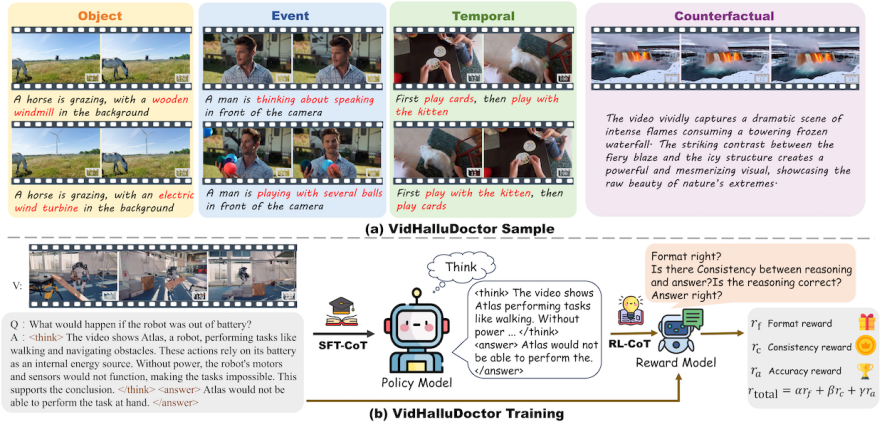
多模态大模型内生安全:缓解视频大模型幻觉
VidHalluDoctor: Learning Video Differences to Mitigate Hallucinations in Vision-Language Models
多模态大模型在视频理解中仍容易产生与真实视觉内容不一致的幻觉,是影响模型安全可信应用的重要问题。为此,本文提出VidHalluDoctor,通过学习视频帧间细粒度差异、减少模型对语言先验的依赖,并结合一致性感知强化学习,有效缓解视频理解中的幻觉问题。本文进一步构建包含10,000个视频的VidHalluEva评测基准,为多模态大模型视频幻觉的系统评估与内生安全研究提供新的测试平台。
论文作者:戴紫赟,付杨,丁恒辉*
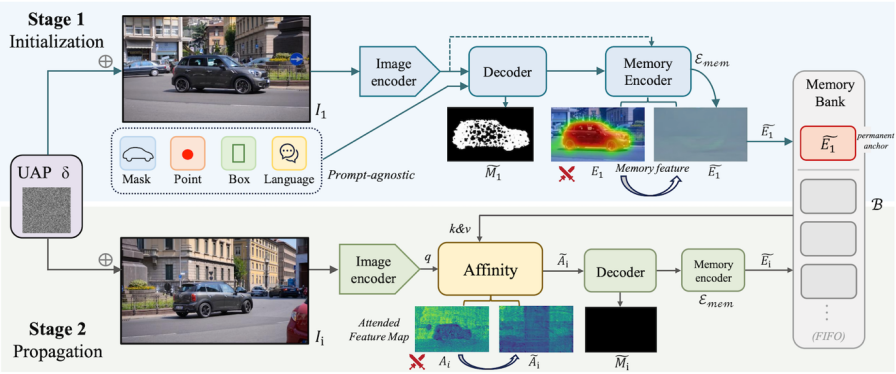
多模态大模型内生安全:揭示视频模型的对抗脆弱性
Attack-Inference Aligned Universal Adversarial Attacks on Video Object Segmentation
随着视觉基础模型逐渐应用于视频理解,其自身推理机制中潜在的安全脆弱性受到越来越多关注。针对现有攻击方法与视频模型实际推理机制不匹配的问题,本文提出AUV,通过对视频目标初始化与时序传播过程进行联合攻击,实现对掩码、点、框和语言等多种提示形式的通用对抗攻击。实验表明,AUV能够有效攻击SAM 3、SAM 2等多种视频模型,揭示了当前视频基础模型在对抗攻击下的安全风险。
论文作者:沈瑞淇,刘畅,丁恒辉*
多模态视频分割:无需训练,让SAM 3更懂自然语言指代
eSAM: Unleashing the Hidden RES Capability of SAM3 via Training-free Attention Editing
根据自然语言描述在图像和视频中精准定位并分割目标,是多模态视觉理解的重要任务。尽管SAM 3已具备文本提示分割能力,但直接应用于复杂指代表达时仍存在明显不足。本文通过分析其多模态注意力机制,提出无需任何额外训练的eSAM,通过直接编辑SAM 3内部的跨模态注意力,增强语言与视觉内容之间的有效交互,在多个图像和视频指代分割基准上取得新的领先性能。
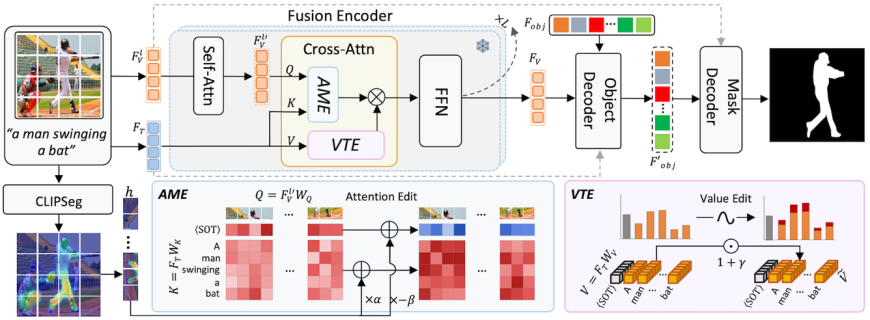
论文作者:王耀霆,周运,胡恒睿,刘畅,丁恒辉*
此外,论文通讯作者丁恒辉入选近日发布的2026年度“全球前2%顶尖科学家”(World’s Top 2% Scientists)年度科学影响力榜单,这也是其连续第三年入选该榜单。该榜单由美国斯坦福大学与爱思唯尔共同发布,基于多维度学术指标综合评估全球科学家的科研影响力。